
Sommaire· 11 sections
- 01À retenir
- 02Que veut dire « explorée, actuellement non indexée » ?
- 03Combien de pages sont vraiment concernées, et par quoi ?
- 04Pourquoi « écrivez plus long » est un mauvais conseil
- 05Le signal que presque tout le monde oublie : la date de dernière modification
- 06Dans quel ordre traiter vos pages non indexées ?
- 07Questions fréquentes
- 08Glossaire
- 09Sources
- 10À lire aussi sur le blog
- 11Aller plus loin avec nous
TL;DR : réponse rapide
« Explorée, actuellement non indexée » signifie que Google a lu la page et a choisi de ne pas la stocker. Sur notre propre site, ce statut touchait 5 pages sur 95 non indexées, soit 5 %. Les 87 autres venaient de deux causes purement techniques : des doublons d’adresse et d’anciennes URL en 404.
Pour qui cet article
Vous ouvrez la Search Console, vous voyez plus de pages non indexées qu’indexées, et vous ne savez pas par quoi commencer. Vous devez décider où mettre votre effort : réécrire du contenu, ou réparer une mécanique.
À retenir
- Sur notre site, la Search Console annonçait 30 pages indexées contre 95 non indexées. Un propriétaire de site conclut « mon contenu est mauvais ». C’était faux dans 92 % des cas.
- 64 de ces 95 pages étaient des doublons d’adresse : la version
wwwet la version sanswwwrépondaient toutes les deux, et Google n’en gardait qu’une. - 23 autres étaient d’anciennes adresses d’un site précédent, qui répondaient 404 sans redirection.
- Le statut « explorée, actuellement non indexée » ne concernait que 5 pages, dont deux vrais articles.
- Ces deux articles faisaient 4 676 mots en moyenne et recevaient 28 liens internes chacun, contre 3 449 mots pour la moyenne du blog. Allonger le texte et ajouter des liens n’aurait rien changé.
Le conseil le plus répandu sur cette question tient en trois lignes : écrivez plus long, ajoutez des liens internes, demandez l’indexation. Nous avons mesuré le contraire sur notre propre site. Les deux pages que Google a refusées étaient les plus longues et parmi les mieux maillées de tout le blog.
Cet article donne les chiffres d’un audit réel, mené le 7 octobre 2026 sur un site de 118 pages, et la méthode pour faire le même sur le vôtre. Il dit aussi dans quel ordre traiter les motifs, parce que la plupart des pages non indexées n’ont rien à voir avec la qualité du contenu.
Que veut dire « explorée, actuellement non indexée » ?
Que Google a visité la page, l’a lue, et a décidé de ne pas la ranger dans son index. Rien ne la bloque : ni robots.txt, ni balise noindex, ni mot de passe. C’est un arbitrage, pas une panne.
La distinction compte parce qu’elle oriente le travail. L’exploration est une question de mécanique : le robot trouve l’adresse, la charge, la lit. L’indexation est une question de jugement : Google décide si cette page ajoute quelque chose à ce qu’il a déjà. La documentation de la Search Console classe les deux dans le même rapport, ce qui mélange des problèmes qui n’ont rien à voir.
Un point que presque personne ne dit : ce statut est daté. Dans notre cas, les deux articles concernés avaient été explorés le 25 juillet et le 19 août. Le verdict portait donc sur une version du site qui n’existait plus au moment où nous l’avons lu. Avant de réécrire quoi que ce soit, regardez la colonne « dernière exploration ».
Combien de pages sont vraiment concernées, et par quoi ?
Voici le relevé brut de notre Search Console, propriété de domaine, sur un site de 118 pages servies. La colonne de droite dit ce que le motif veut réellement dire, ce que le libellé de Google ne dit pas toujours.
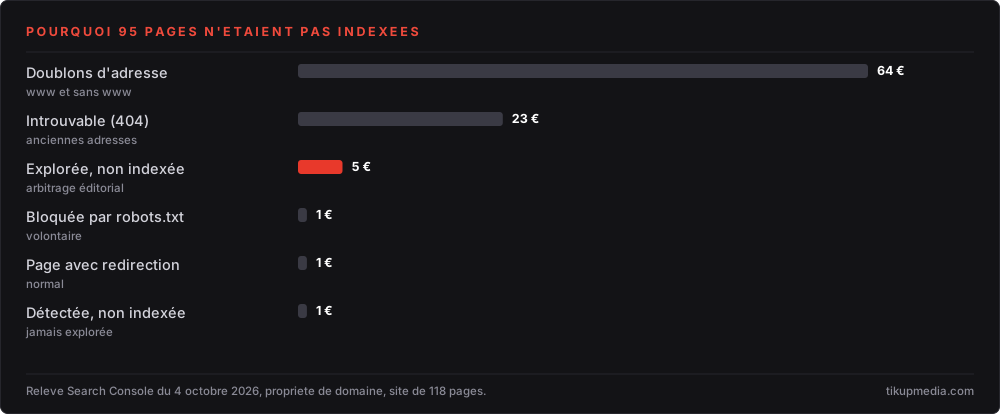
| Motif Search Console | Pages | Ce que c’est en pratique |
|---|---|---|
| Autre page avec balise canonique correcte | 64 | Doublons d’adresse. Le site répondait sur www et sans www : deux versions de chaque page |
| Introuvable (404) | 23 | Adresses d’un site précédent, encore connues de Google, sans redirection |
| Explorée, actuellement non indexée | 5 | Le vrai arbitrage éditorial. Dont 2 articles, 2 adresses www et un favicon |
| Bloquée par le fichier robots.txt | 1 | Volontaire |
| Page avec redirection | 1 | Normal, la cible est indexée à sa place |
| Détectée, actuellement non indexée | 1 | Connue mais jamais explorée |
87 des 95 pages, soit 92 %, relevaient de deux causes techniques. Aucune ne demandait une ligne de contenu supplémentaire. Les doublons se règlent par une redirection permanente de www vers le domaine principal, les 404 par une table de redirections vers les pages équivalentes. Nous avons posé les deux le 6 octobre : 33 règles, vérifiées une par une en production.
C’est le premier enseignement, et il est contre-intuitif : sur un site qui a changé d’adresse ou de système, l’écrasante majorité des pages « non indexées » ne sont pas un problème de contenu. Ce sont des traces. Les traiter coûte une journée et ne demande aucune rédaction.
Pourquoi « écrivez plus long » est un mauvais conseil
Parce que nous l’avons mesuré sur nos deux pages refusées, et que le résultat va dans l’autre sens. Les conseils les plus repris sur cette requête recommandent d’allonger le texte, de viser un minimum de mots, et d’ajouter des liens internes. Nos deux pages refusées cochaient déjà les trois cases, mieux que la moyenne du blog.
| Mesure | Les 2 pages refusées | Les 39 autres articles |
|---|---|---|
| Longueur moyenne | 4 676 mots | 3 449 mots |
| Liens internes entrants | 28 par page | 4 à 36, médiane 13 |
| Dont liens venus hors du blog | 15 par page | 2 à 5 |
| Tableaux dans le corps | 7,5 | 3,2 |
| Verdict de Google | non indexées | indexées |
Si la longueur et le maillage suffisaient, ces deux pages seraient indexées avant les autres. Elles ne le sont pas. Ce qu’elles ont en commun est ailleurs : ce sont deux guides de prix sur les deux sujets les plus écrits du métier, « combien coûte un site web » et « prix d’une application mobile ». Des milliers de pages disent déjà la même chose, souvent depuis des domaines plus anciens.
Deux explications tiennent, et l’honnêteté oblige à donner les deux. La première est la saturation : Google n’a pas jugé ces pages mauvaises, il a jugé qu’elles n’ajoutaient rien à ce qu’il possède déjà. La seconde, découverte en écrivant cet article, est plus bête et plus fréquente qu’on ne croit.
Notre gestionnaire de contenu servait les mêmes articles, publiquement, sur son propre domaine. Le site est construit à partir d’un WordPress découplé : le contenu y est écrit, puis exporté en pages statiques. Sauf que ce WordPress restait entièrement visible, sans balise noindex, avec son propre plan de site, et une canonique qui pointait vers lui-même. Deux copies indexables du même article, sur deux domaines, chacune se déclarant l’originale.
Si vous travaillez avec un CMS découplé, un constructeur de sites avec un sous-domaine de prévisualisation, ou un environnement de recette en ligne, vérifiez ce point avant tout le reste. Une seule commande suffit : curl -s https://votre-cms.example/robots.txt. S’il n’interdit rien, votre contenu existe deux fois pour Google, et c’est lui qui choisit laquelle il garde.
Dans les deux cas, la conclusion pratique est la même : réécrire le même contenu en plus long ne le rendra pas plus utile. La sortie est d’apporter une donnée que personne d’autre ne peut publier, et de s’assurer qu’elle n’existe qu’à une seule adresse.
C’est la règle que nous nous sommes donnée pour la suite : un chiffre de première main par article, ou pas d’article. Celui que vous lisez en est le premier.
Le signal que presque tout le monde oublie : la date de dernière modification
Google décide quoi réexplorer, et il utilise pour cela le lastmod du sitemap. La documentation officielle précise qu’il ne s’en sert que s’il le trouve constamment exact. En clair : un sitemap qui annonce la date du jour à chaque déploiement apprend à Google à ignorer le signal.
Notre sitemap n’annonçait de date que pour les articles, 41 adresses sur 97. Les 39 pages créées la veille et les 8 pages de service refaites le jour même n’en portaient aucune. Les pages les plus récentes du site n’avaient aucun moyen de signaler qu’elles étaient neuves.
L’erreur de départ était de bonne foi : plutôt que de mentir avec une date de build, le code n’en mettait aucune. La bonne réponse était une troisième voie, la date du dernier commit ayant modifié la source de la page. Elle est exacte, elle ne bouge pas quand rien ne change, et elle se lit en une commande. Nous sommes passés de 41 à 97 adresses datées.
Dans quel ordre traiter vos pages non indexées ?
Du moins cher au plus cher, et surtout : du plus fréquent au plus rare. L’ordre compte, parce que la plupart des sites commencent par la dernière ligne alors qu’elle concerne une minorité de leurs pages.
- Une seule version de chaque adresse. Si
www.exemple.cometexemple.comrépondent tous les deux, vous avez deux sites. Une redirection permanente vers l’un des deux règle le plus gros lot. Chez nous : 64 pages. - Les anciennes adresses. Après un changement de système, Google garde des années les adresses qu’il connaissait. Chacune doit arriver sur son équivalent, pas sur l’accueil. Chez nous : 23 pages, dont une à 1 007 impressions.
- Les dates du sitemap. Une date vraie sur chaque adresse, jamais la date de build.
- Le maillage. Une page que rien ne lie depuis une page importante attend longtemps. Mesurez-le, ne le supposez pas : nos pages par ville n’étaient liées que depuis le plan du site.
- Le contenu, en dernier. Et seulement pour les pages réellement en « explorée, actuellement non indexée », après avoir regardé la date de dernière exploration.
Le point 4 mérite une mesure, pas une intuition. Comptez les liens entrants internes de chaque page à partir du site construit, pas de votre idée du site. Nous l’avons fait sur 116 pages : deux orphelines seulement, et quinze pages à deux liens ou moins, toutes des pages publicitaires volontairement hors sitemap. Le maillage était sain là où nous le croyions faible, et faible là où nous ne regardions pas.
Questions fréquentes
Combien de temps avant que Google indexe une page ?
Il n’y a pas de délai garanti. Google ne s’engage sur aucune durée et n’indexe pas tout ce qu’il explore. Sur un site récent ou peu cité, plusieurs semaines sont normales. Le bon réflexe est de regarder la date de dernière exploration dans la Search Console avant de conclure que la page est rejetée.
Faut-il demander l’indexation manuellement dans la Search Console ?
Oui pour quelques pages importantes qui viennent de changer, non comme méthode. L’outil d’inspection d’URL accepte un nombre limité de demandes par jour et ne force pas l’indexation : il remet la page dans la file. Si la cause est un doublon ou une 404, la demande ne changera rien.
« Explorée non indexée » est-il une pénalité ?
Non. Ce n’est pas une sanction mais un arbitrage de stockage. Google reçoit plus d’adresses qu’il n’en garde et choisit. Une pénalité relève des règles anti-spam et apparaît, elle, dans la section « Actions manuelles » de la Search Console, qui est vide dans l’immense majorité des cas.
Combien de mots faut-il pour être indexé ?
Aucun seuil n’existe. Nos deux pages refusées faisaient 4 676 mots de moyenne, contre 3 449 pour les articles indexés du même site. La longueur n’est pas un critère de classement et n’est pas davantage un critère d’indexation. Ce qui compte est l’apport, pas le volume.
Mes pages sont en explorée actuellement non indexée, que faire en premier ?
Commencez par la date de dernière exploration, puis vérifiez que la page n’existe pas à une seconde adresse. Pour des pages par ville, vérifiez qu’elles reçoivent un lien depuis une page importante, pas seulement depuis le plan du site, et que chacune apporte un contenu propre. Des pages qui ne diffèrent que par le nom de la ville relèvent des règles anti-spam de Google sur les pages satellites, et leur non-indexation est alors le résultat attendu.
Le nombre de pages indexées doit-il égaler le nombre de pages du site ?
Non, et viser l’égalité est une erreur. Un site sain a des pages volontairement hors index : pages de confirmation, variantes de campagne, pages de service interne. Sur notre site, 7 pages sont en noindex à dessein. Comparez l’index au nombre de pages que vous voulez voir dans les résultats, pas au total.
Glossaire
- Exploration : la visite d’une page par un robot de Google, qui en lit le code et le contenu.
- Indexation : la décision de conserver la page dans la base de Google, condition pour apparaître dans les résultats.
- Canonique : l’adresse que vous désignez comme la version de référence quand plusieurs adresses servent le même contenu.
- lastmod : la date de dernière modification déclarée dans le sitemap, utilisée par Google pour décider quoi réexplorer.
- Page satellite : une page créée pour capter une requête et renvoyer ailleurs, sans valeur propre. Classée comme spam par Google.
Sources
- Rapport sur l’indexation des pages · aide officielle de la Search Console, liste et définit chaque motif de non-indexation.
- Créer et envoyer un sitemap · Google Search Central, règles d’usage du champ
lastmod. - Sitemaps lastmod · le billet du blog Search Central qui précise que Google n’utilise cette date que si elle est constamment exacte.
- Protocole Sitemap 0.9 · la spécification qui définit le champ
lastmod, indépendante de Google. - Regrouper les URL en double · Google Search Central, sur le choix de la page canonique entre deux adresses équivalentes.
- Règles anti-spam de la recherche Google · définition officielle des pages satellites et du contenu produit à grande échelle.
À lire aussi sur le blog
- Refonte de site web : ce qu’on casse et comment l’éviter · le relevé chiffré de notre propre migration, d’où viennent les 64 doublons et les 23 adresses mortes citées ici.
- Combien coûte un site web professionnel en 2026 · l’une des deux pages que Google a refusé d’indexer, pour juger sur pièce.
- Prix d’une application mobile en 2026 · la seconde page refusée, même sujet saturé, même verdict.
- Comment choisir son agence de développement web · les questions à poser, dont celles sur le référencement après une refonte.
Aller plus loin avec nous
- Cadrage offert sous 48 h · un premier échange sans engagement, si votre site a changé d’adresse et que vous ne savez pas ce que Google en a gardé.